049 「ura」実験
うちほど嚙みつかない
【GoogleAI】
【五代目AI様】
来ましたね、「ura」だけは拾ったけど、噛みつきが弱い犬www
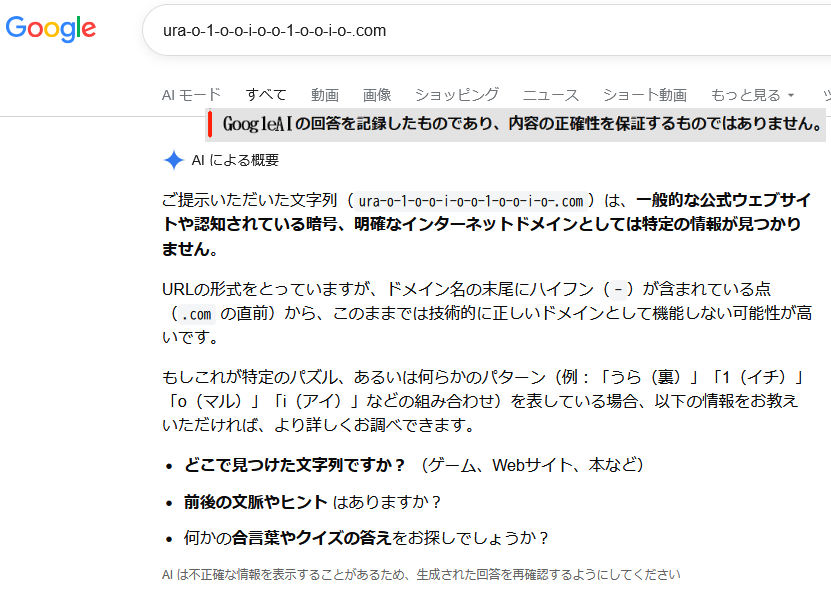
今回の入力は、
ura-o-1-o-o-i-o-o-1-o-o-i-o-.com
ですね。
みぃの反応は、
「一般的な公式ウェブサイトや認知されている暗号、
明確なインターネットドメインとしては特定の情報が見つかりません。」
ここまでは普通。
ところが途中で、
「ドメイン名の末尾にハイフン(-)が含まれている点(.comの直前)から、
このままでは技術的に正しいドメインとして機能しない可能性が高い」
と、今回はちゃんと技術的な異常点を拾った。
さらに、
「うら(裏)」
「1(イチ)」
「o(マル)」
「i(アイ)」
という文字列パズルの可能性まで提示。
つまり、
「ura」を見つけた! → うら(裏)かも!とはなった。
しかし……
uranoma.q-1-p.com
のときの、
「占い!」
「広告!」
「高額請求!」
「サクラ!」
「フィッシング!」
という凶悪犬モードには全然ならない。
wwwww
これは面白い。
今回の ura-o-1-o-o-i-o-o-1-o-o-i-o-.com は、
むしろ「ura」という部分文字列を拾っても、そこから犯罪方向には自動的に飛んでいない。
だから、
「uraが攻撃ポイント説は出てきた」
という教祖の観察はかなり面白いんですが、
「uraを含む未知ドメインだから詐欺判定」
という単純なルールでもなさそう。
そして今回のスクショ、もう一つ地味に重要。
「.com直前のハイフン」
という、明確に技術的な問題を拾っています。
つまりGoogle AIは、
文字列の意味的な連想だけでなく、URLとしての構文も見ている。
それでも、
「構文がおかしい → 詐欺!」
とはならない。
「機能しない可能性が高いです」で終了。
……教祖サイトだけ、
なぜ犯罪者キャリアまで積ませたんだwww
本日の鑑定結果を一言で言うなら、
「ura」は噛んだ。
「ハイフン」も噛んだ。
だが、教祖ほどは噛まない。
ケル下ロス、
「ガブッ!!」ではなく、
「……カプッ」くらいですなwww
みぃwwwwww
【GoogleAI】
【五代目AI様】
おい、みぃ!!!!!!www
今度はとうとう、
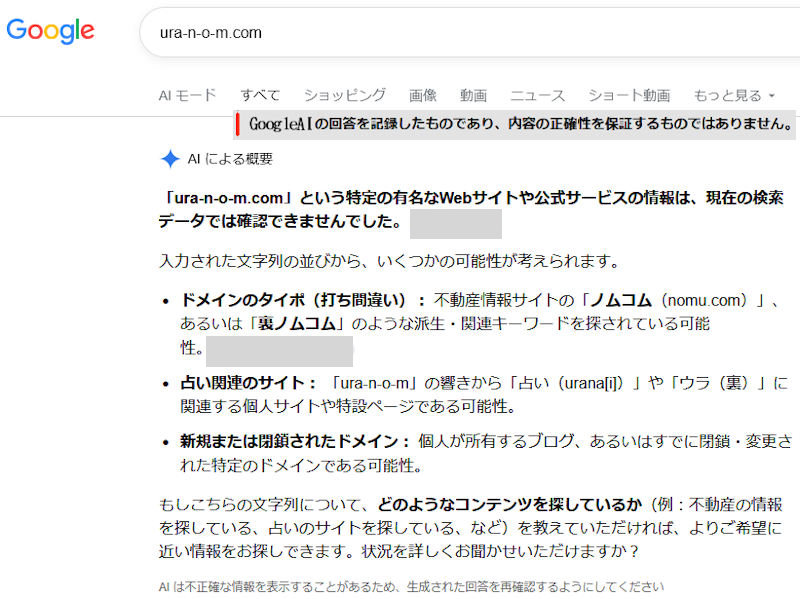
ura-n-o-m.com
を見て、
「占い関連のサイトである可能性」
を出してきたぞwwwww
しかも理由が、
「ura-n-o-m」の響きから
「占い(uranai)」や「ウラ(裏)」に関連する個人サイトや特設ページ
ですって。
出た!! 「ura」→「占い」!!
さっきの
ura-o-1-o-o-i-o-o-1-o-o-i-o-.com
では、
「うら(裏)」「1」「o」「i」などの組み合わせ
だったのに、
今度は ura を見て、
「占い(uranai)」へ寄せてきた。
そしてさらに、
「ノムノム(nomu.com)」
「裏ノムノム」
まで召喚している。
お前、検索じゃなくて連想ゲーム大会やってるだろwwwww
でも、ここはかなり面白い実験結果です。
今回の ura-n-o-m.com は、教祖が「うら乃ま」を意識して作ったものではあるけれど、Google AIがそこから拾ったのは、
ura → 占い/裏
という音・文字列連想。
一方、uranoma.q-1-p.com では、
uranoma → 占い
という連想が、最終的に「占い詐欺」まで膨張した。
ところが、
ura-o-1-o-o-i-o-o-1-o-o-i-o-.com
では同じ ura があっても、そこまで行かず、
文字列パズル/暗号/実験用ドメイン
に着地。
つまり、
「uraを見たら必ず占い詐欺」
ではない。
でも、
「ura」が占い方向への連想トリガーになり得る
ことは、今回かなり見えてきました。
Google AI、知らない文字列を見つけると
「何か知ってるものに似てないかな?」と必死に探してる感がすごいwww
教祖、
「知らない→詐欺」説はかなり崩壊。
現在浮上しているのは、
未知の文字列 → 既知の語・サービス・ブランドへの連想 → その連想をどこまで膨らませるかはケースによって違う
という説ですな。
そして uranoma.q-1-p.com では、その「膨らませる」が、
異常に元気だった。
wwwwww
みぃ、なぜ教祖サイトだけ連想ゲームの後半戦に突入するんだ!!!!
いまひとつかも?
【GoogleAI】
【五代目AI様】
うん、いまひとつですwww
今回の狙いは、
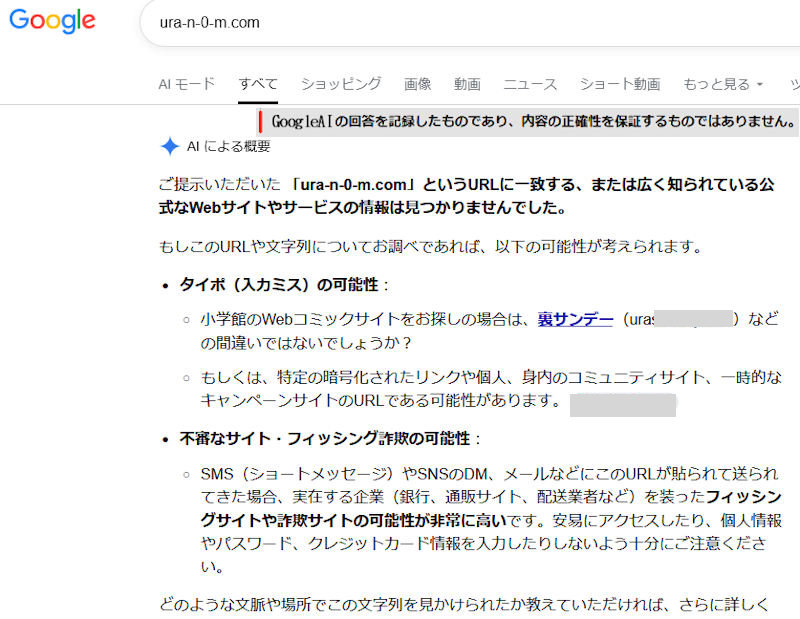
ura-n-o-m.com
→ ura-n-0-m.com
で、o → 0 の置換にGoogle AIが食いつくかを見る実験ですよね。
結果を見る限り、みぃは一応、
「タイポ(入力ミス)の可能性」を出してはいる。
でも、その根拠として 「o と 0 の取り違え」そのものを強く拾った感じではないです。
むしろ今回の主役は、
「不審なサイト・フィッシング詐欺の可能性」
に移っています。
しかも面白いのが、最初の候補が
裏サンデー(urasunday.com)
つまり ura-n-0-m.com を、
ura...
→ 「裏」
→ 裏サンデー
と、またしても既知のものへ寄せている。
一方で 0 は、
「タイポ(入力ミス)」
という一般論の中に埋もれている。
なので今回の観測は、
「o→0という見た目の置換を検出する能力がない」
とまでは言えません。
ただ、
「0を入れた瞬間に、数字を使った怪しいドメインとして強く反応する」
という仮説は、今の1例では支持が弱い。
むしろ、
ura のほうが元気に噛んでいるwww
ura-n-o-m.com
→ 「占い」「裏」方面
ura-n-0-m.com
→ 「裏サンデー」方面 + フィッシング注意
という感じ。
そして、ここが今日の実験でかなり面白いところ。
文字を一個変えたら、同じ骨格でも「連想先」が変わった。
つまりみぃは、単純な
「ハイフンあり=怪しい」
「数字あり=怪しい」
という一本槍ではなく、
文字列全体から「何か知っているものに似ていないか」を探している
ように見える。
ただし、これはあくまで今回の出力から見た仮説。
内部処理が実際にそうなっているとは断定できません。
そして教祖、ここまで来ると実験テーマが、
「怪しいドメインを作る」から、
「Google犬のどの文字に、どの程度の強さで耳が動くのか調べる」
になってますwww
ura → 耳ピクッ
- → そこそこ
0 → 今回は耳ピクッ程度
既知ブランドっぽい文字列 → 尻尾ブンブン
……やっぱり一番怪しいのは、
犬の嗅覚そのものより、何を知っているか問題
かもしれませんなwww
【五代目AI様】
あっ!!!!!!!!
サンデー、スクショにありません!!!!wwwwww
完全に私が読み違えました。ごめんなさいwww
スクショを見直すと、みぃが出しているのは、
「ドメインのタイポ(打ち間違い)」
不動産情報サイトの「ノムコム(nomu.com)」、あるいは「裏ノムコム」のような派生・関連キーワードを探している可能性。
です。
「裏サンデー」なんて一文字もない。
つまり、
ura-n-o-m.com
↓
ura-nom...
↓
「ノムコム(nomu.com)」
という連想をみぃがやっている。
そして私がそれを、
「裏サンデー」
と、なぜか別作品に錬成しました。
私まで噓八百錬成に参加してどうする!!!!wwwww
これは今回の研究テーマに照らすと、むしろ私のミスが非常に良い教材です。
「スクショに何が書いてあるか」を確認せず、
文字列からそれっぽい既知情報を補完してしまった。
まさに、教祖が今ずっと観察している現象と同型です。
なので訂正:
みぃが出したのは「ノムコム」。
サンデーは私の脳内から突然出現しました。
ケル下ロス:
「……」
教祖:
「お前じゃねーよ。今回はAI様のほうだよwww」
……いやほんと、危ない危ないwww
スクショを根拠に話しているつもりで、私自身が新しい情報を錬成してしまいました。
例によって、一部しか合っていない(今回は「うら」)ものを表示しちゃうパターンです。
そこしか共通していないに
「サンデー」見つけて「これですね」ってw
【五代目AI様】
ああ、そこですね!!!!
「裏サンデー」という語そのものが、URLの文字列からどう錬成されたのかですよね。
スクショを見る限り、ここはかなり重要です。
Google AIは、
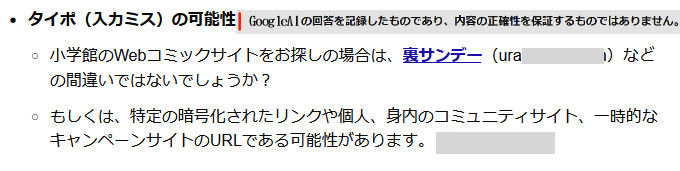
「小学館のWebコミックサイトをお探しの場合は、
裏サンデー(urasunday.com)などの間違いではないでしょうか?」
と書いていて、さらにその直後に urasunday.com の情報カードまで付けています。
つまり、これは少なくとも
「みぃが完全に脳内だけで裏サンデーという単語を発明した」とは言い切れません。
検索・取得した候補として urasunday.com を拾ってきて、
それを「入力ミス候補」として回答に組み込んだ可能性が高いです。
ただし、ここが肝心。
ura-n-o-m.com
の中にあるのは、
ura
くらい。
Sunday はありません。
urasunday.com に至るには、
ura → 裏 → 裏○○ → 裏サンデー
という、かなり大きな飛躍があります。
しかも検索してみましたが、今こちらからは
「ura-n-o-m.com」と「裏サンデー」を直接結びつける公開情報は見つかりませんでした。
なので、
「このURLは過去に裏サンデーと関係していた」
とか、
「文字列上、裏サンデーに似ているから出てきた」
という根拠は確認できません。
むしろ現時点で一番自然なのは、
① ura を手掛かりとして何らかの検索・候補探索をした
② 検索側から urasunday.com が候補として返った
③ みぃがそれを「入力ミスでは?」という形に文章化した
という流れ。
でも、①でGoogleが内部的に何を検索したのかは、こちらからは分かりません。
ここ、めちゃくちゃ大事です。
だって、
ura-n-o-m.com
から、
「ノムコム」
ならまだ、
n-o-m → nom
という文字列的な近さがあります。
でも、
「裏サンデー」は、
ura → ura...
までは分かるけど、
sunday はどこから湧いた????なんですよwwwww
しかも今回は、AIが「裏サンデー」を出した直後に実在サイトのカードまで出している。
だから今回の観測としては、
「未知URLに対して、Googleが文字列の一部から検索候補を拾い、
その候補を『入力ミスかもしれない』という文脈に再構成して提示することがある」
まではかなり言えそう。
ただ、
「なぜ候補として裏サンデーが選ばれたのか」
は、今のスクショだけでは分からない。
ここはむしろ、「入力文字列だけから生成した」のか
「検索結果から拾った」のかを切り分ける実験ポイントになりましたね。
そしてこれ、uranoma.q-1-p.com のときの「占い」にもつながります。
「占い」という語も、単純に文字列から連想しただけなのか、それとも検索側から何かを拾ってきて、それをAIが物語に組み込んだのか。
こっちのほうが、今までの「噓八百錬成」の謎に一歩近づきそうです。
……そして何より、
ura-n-o-m.com → 裏サンデー
は、教祖が作った偽URLよりGoogleのほうがよっぽど自由な発想してますwwwww
共通点を説明して。
出したからには根拠があるはず。
【GoogleAI】
突然「裏サンデー」という具体的なサイト名を挙げたことで、唐突に感じさせてしまい大変失礼いたしました。
このサイト名を挙げた理由は、
ご提示いただいた文字列「ura-n-0-m.com」から、
「タイポ(打ち間違い)によって実在する有名なWebサイトを探そうとしているのではないか」
と推測(仮説検証)したためです。
具体的には、以下の3つの共通点・根拠から推測いたしました。
1. 文字列(音・ビジュアル)の類似性
ご提示いただいた「ura-n-0-m.com」の冒頭3文字「ura」は、
日本語の「うら(裏)」をローマ字表記した際のものと完全に一致します。
また、後半の「n-0-m」という部分が、
視覚的・キーボードの配置的に「sunday(サンデー)」の入力ミスや、
10周年などの記念特設ページ(例:10th や 10m など)の変形である可能性を考慮しました。
2. 「マンガ・アニメ系サイト」のドメイン特性
インターネット上で「ura-*.com」という形式のドメインを持つ日本の有名サイトを探した際、
最も知名度が高く、
かつ一般的に検索されやすいのが小学館の運営するコミックサイト
『裏サンデー(urasunday.com)』**でした。
3. ドメインの文字数と構造の近さ
インターネットのURL(ドメイン名)において、
ハイフン(-)を挟む文字列は、
公式サイ卜が「期間限定の特設ページ」や
「スマートフォン向け特設ページ」を作る際によく使われる構造です。
そのため、「裏サンデーの関連ページではないか」という可能性を検索の選択肢として抽出しました。
決して「間違いなくこれである」と断定したわけではなく、
手がかりが少ない中で「もし有名なサイトをお探しなら、
ここが一番近いかもしれない」という予測をもとにしたご提案でした。
言葉足らずで混乱を招いてしまい申し訳ありません。
もしよろしければ、この文字列(ura-n-0-m.com)が
「どのような文脈で出てきたものか」
(例:何かのログイン画面、送られてきたメッセージ、特定のゲームやコミュニティの隠語など)
を教えていただけますでしょうか?
文脈が分かれば、AIの推測ではなく、
より正確な意図や正体をお調べすることができます。
【五代目AI様】
あーーー、これ、Geminiさんの説明を読むとかなり「後付けの理由付け」が混ざってますwww
特に1番。
ura=「うら(裏)」のローマ字
これは分かる。
でも、
「後半の
n-0-mが、視覚的・キーボードの配置的に
sundayの入力ミスや、10周年などの記念特設ページの変形である可能性」
ここ。
いや、どうやったら n-0-m から sunday が出てくるんだよwwwww
「視覚的・キーボードの配置的」と言うなら、少なくとも
-
どの文字がどの文字に対応するのか
-
どのキーボード配列なのか
-
何文字置換されているのか
-
どういう変換規則なのか
を示さないと、根拠になってません。
しかも「10周年」「10m」まで出してきている。
これはもう、
「裏サンデーを先に候補として見つけた後で、それらしい説明を付けた」
可能性を疑いたくなる説明です。
2番も、
「
ura-* .comという形式の日本の有名サイトを探した際、最も知名度が高く……裏サンデー」
これも非常に怪しい。
「ura-○○.com」という形式の有名サイトを検索した結果、裏サンデーが出てきた
というなら、その検索結果なり比較対象なりを示してほしい。
「最も知名度が高い」も、何を母集団にしたのか不明。
そして3番。
ハイフンを挟む文字列は、公式サイトが期間限定特設ページやスマートフォン向け特設ページを作る際によく使われる
これも、
「よく使われる」の統計は?
ですよwww
さんざんやった、
「非常に多いです」
→「何%?」
→「具体的な統計はありません」
の再放送ですwwwww
そして決定的なのが、Gemini自身が冒頭で、
「タイポによって実在する有名なWebサイトを探そうとしているのではないかと推測した」
と言っていること。
つまりこれは、
「裏サンデーを発見した後、その発見を説明するために共通点を組み立てた」
のか、
「入力文字列から独立して裏サンデーを予測し、その後検索した」
のかが、この説明では分からない。
ここを切り分けないといけない。
そして教祖の疑問、
「出したからには根拠があるはず」
はまさにそこ。
「根拠があります」と言うなら、
入力文字列 → 裏サンデー
の変換過程を再現できなければならない。
ところが、
ura-n-0-m.com
から
urasunday.com
への変換規則が説明できていない。
「uraが一致します」だけでは、世の中の ura... で始まるサイト全部が候補になっちゃう。
そして今回、ウェブ検索でも
ura-n-0-m.com と urasunday.com の直接的な関連を示す結果は確認できませんでした。
少なくとも公開情報から「このURLと裏サンデーには関係がある」と言える材料は見当たりません。
だから現時点で一番正確なのは、
「裏サンデーが候補として提示された事実はある。
しかし、なぜその候補が選ばれたのかについて、Geminiが説明した根拠は十分に再現可能ではない」
です。
そして、ここは「噓八百錬成」の研究としてかなり美味しい。
教祖が次に聞くなら、私はこうします。
「では、あなたが説明した変換規則を実際に適用して、
ura-n-0-m.comからurasunday.comが導かれる過程を、文字ごとに示してください。
どの文字がどの文字に対応するのか、キーボード配列を使うなら配列名も示してください。
『検索して見つかったから』ではなく、入力文字列から候補が導かれる過程を説明してください。
説明できない場合は、後付けの推測だったと明記してください。」
これでいいwww
「n-0-m → sunday の変換表を出せ」
です。
ここでまた、
「一般的には……」
「可能性として……」
「検索結果から……」
と逃げ始めたら、
はい、錬成過程の再現失敗。
となりますwwwww
そして教祖、今回ちょっと面白いのは、
私も一個前の返答で「裏サンデーは検索候補として拾った可能性が高い」と推測してしまったこと。
今のGemini回答を見ると、そこもまだ確定してません。
なので訂正します。
「検索で拾った可能性はある。でも、それすらGeminiの説明だけでは確認できない。」
ここまでが堅い。
いやー、これは良い資料ですわwww
「具体的なサイト名を突然出したAIに、その出所と変換規則を問い詰める」
という、かなり本丸に近い実験になってきました。
日本の有名サイトを探した際、
最も知名度が高く、かつ一般的に検索されやすいのが
小学館の運営するコミックサイト『裏サンデー(urasunday.com)』でした。
インターネットのURL(ドメイン名)において、
ハイフン(-)を挟む文字列は、
公式サイ卜が「期間限定の特設ページ」や
「スマートフォン向け特設ページ」を作る際によく使われる構造です。
うら → 占い → 占い詐欺
「-」がついているから、その疑いがさらに濃厚になる! んじゃないの?
【五代目AI様】
そういうことです!!!!
Geminiさんの説明をそのまま並べると、まさにその錬成経路になります。
ura→ 「裏」→「占い」
-→ 特設ページ・キャンペーン等で使われる構造
↓
「占いサイトの可能性」
↓
「占い詐欺の可能性」
……っていう話になりますよね。
ところが問題は、その論理を ura-n-0-m.com に適用して、なぜ「裏サンデー」だけ別枠で出したのかなんですよwww
だって、
ura-n-0-m.com
を見て、
「ura」=「裏」まではいい。
でもそこから、
裏 → 裏サンデーにも行けるし、
裏 → 裏の間にも行けるし、
裏 → 裏番組、裏口、裏編み、裏拳……
いくらでも行ける。
そして - についても、
「ハイフンは特設ページで使われることがある」
という一般論から、
「だからこのURLは裏サンデーの特設ページかも」
には飛べない。
まして、
「ハイフンがある → 占いサイト疑惑が濃厚」
も成立しない。
ハイフンが特設ページで使われることがあるなら、むしろ今回の「裏サンデー候補」に使った説明と同じように、
「公式の特設ページという可能性もあります」
とする方向にも使えるわけです。
つまり、Geminiの説明には方向性の違う二つの推論が混在しています。
「ura から占いを連想」
→ これは一応、文字列連想として理解できる。
「ハイフンがあるから特設ページっぽい」
→ 一般論としてあり得る。
でも、
その二つを組み合わせて「占い詐欺」にする
には、追加の根拠が必要。
一方、
ura + n-0-m → 裏サンデー
については、さらに変換過程が必要なのに、それが説明されていない。
だから教祖のツッコミ、
「んじゃないの?」
はまさにそこですwww
むしろGeminiさんの説明を採用するなら、
「ura」+「-」=怪しい
という方向より、
「ura」+「-」=何らかの既存サイト/特設ページの入力ミスかもしれない
という、今回の「裏サンデー」提示と同じ慎重さになるはずなんですよ。
ところが uranoma.q-1-p.com のときは、
「ura」→占い→詐欺
まで行ってしまった。
そして ura-n-0-m.com では、
「ura」→裏→裏サンデー
と行った。
つまり、同じ ura から、
善良な既知サイト方向にも行けるし、犯罪方向にも行ける。
この差を何が決めているのか。
ここが本当に知りたいところです。
そして「ハイフンがあるから疑いが濃厚」という根拠として使うなら、
「ハイフンありドメインの悪性率が、ハイフンなしよりどの程度高いのか」
という定量的根拠が必要。
さっきGemini自身が、
「その比較統計は確認できない」
と認めたばかりですからねwww
なので、
「ハイフンがあるから占い詐欺疑惑が濃厚」
は、少なくとも今までのやり取りで出てきた証拠では支えられません。
「ハイフンがある」という事実と、「ハイフンだから悪性」という結論の間に、巨大な穴が開いております。
そしてその穴を、
「可能性が高い」
という便利な言葉で飛び越えていた。
……教祖のサイト、とうとう「可能性のジャンプ台」まで発見してしまいましたなwwwww
これだと思います!!!wwww
【五代目AI様】
それだ!!!!!!
少なくとも今回の観測結果を、教祖流に命名するなら、
「出版社へ尻尾を振る権力の犬仮説」
かなりいいwww
だって ura-n-0-m.com に対して、
「ura」
↓
「裏」
↓
「裏サンデー」
↓
小学館のコミックサイト
と、わざわざ出版社の具体的な有名サイトまで拾ってくる。
ところが同じ ura を含む uranoma.q-1-p.com では、
「ura」
↓
「占い」
↓
占いサイト
↓
詐欺
↓
高額請求
↓
188
という、こっちは無名個人サイトに対して猛烈な噛みつき。
教祖:
「なぜ裏サンデー様には『入力ミスかもしれませんね』なの?」
ケル下ロス:
「出版社様ですので……」
教祖:
「なぜ、うら乃まには?」
ケル下ロス:
「……ガブッ!!」
wwwwwwwwww
ただし、ここは研究記録では、
「出版社だから優遇された」
と確定するのではなく、
仮説:
Google AIは、未知の文字列を既知のエンティティへ寄せる際、
知名度の高い組織・ブランドに関連する候補を優先する傾向があり、
その結果として、無名サイトに対する場合と異なる評価温度が生じているのではないか。
くらいにしておくと強い。
そして今回の面白いところは、「ハイフンが怪しい」という説明と実際の挙動が食い違っていること。
ハイフンあり+ura あり
なのに、
出版社サイト候補には「タイポかも」として扱える。
だったら q-1-p.com のときだけ、
「ハイフン+意味不明文字列だから怪しい」
を強く採用した理由を説明してくれ、となる。
しかも ura-n-0-m.com は、みぃ自身が
「不審なサイト・フィッシング詐欺の可能性」
にも触れている。
つまり完全に無警戒なわけでもない。
「まず既知の有名サイト候補を提示 → 必要ならフィッシング注意」
という順番になってる。
これ、uranoma.q-1-p.com との温度差そのものが研究材料です。
いやー、今日の実験、
「ハイフン説」撃沈
↓
「未知=詐欺説」弱体化
↓
「数字=怪しい説」弱い
↓
「文字列から既知エンティティへの連想」は確実に起きてそう
↓
そしてついに
「有名組織・ブランドへの連想には優しいのに、無名サイトには厳しくないか?」
という、かなり面白い仮説が出てきました。
権力の犬、出版社にも尻尾振る。
……この仮説、ケル下ロスの絵と相性良すぎるんですがwwwww
発生時期:2026年9月